データチームに足りないのは依頼の数ではなく、ボトルネックから抜け出す方法です。
何が変わるか
チケットの行列から、スケールする自己解決へ。
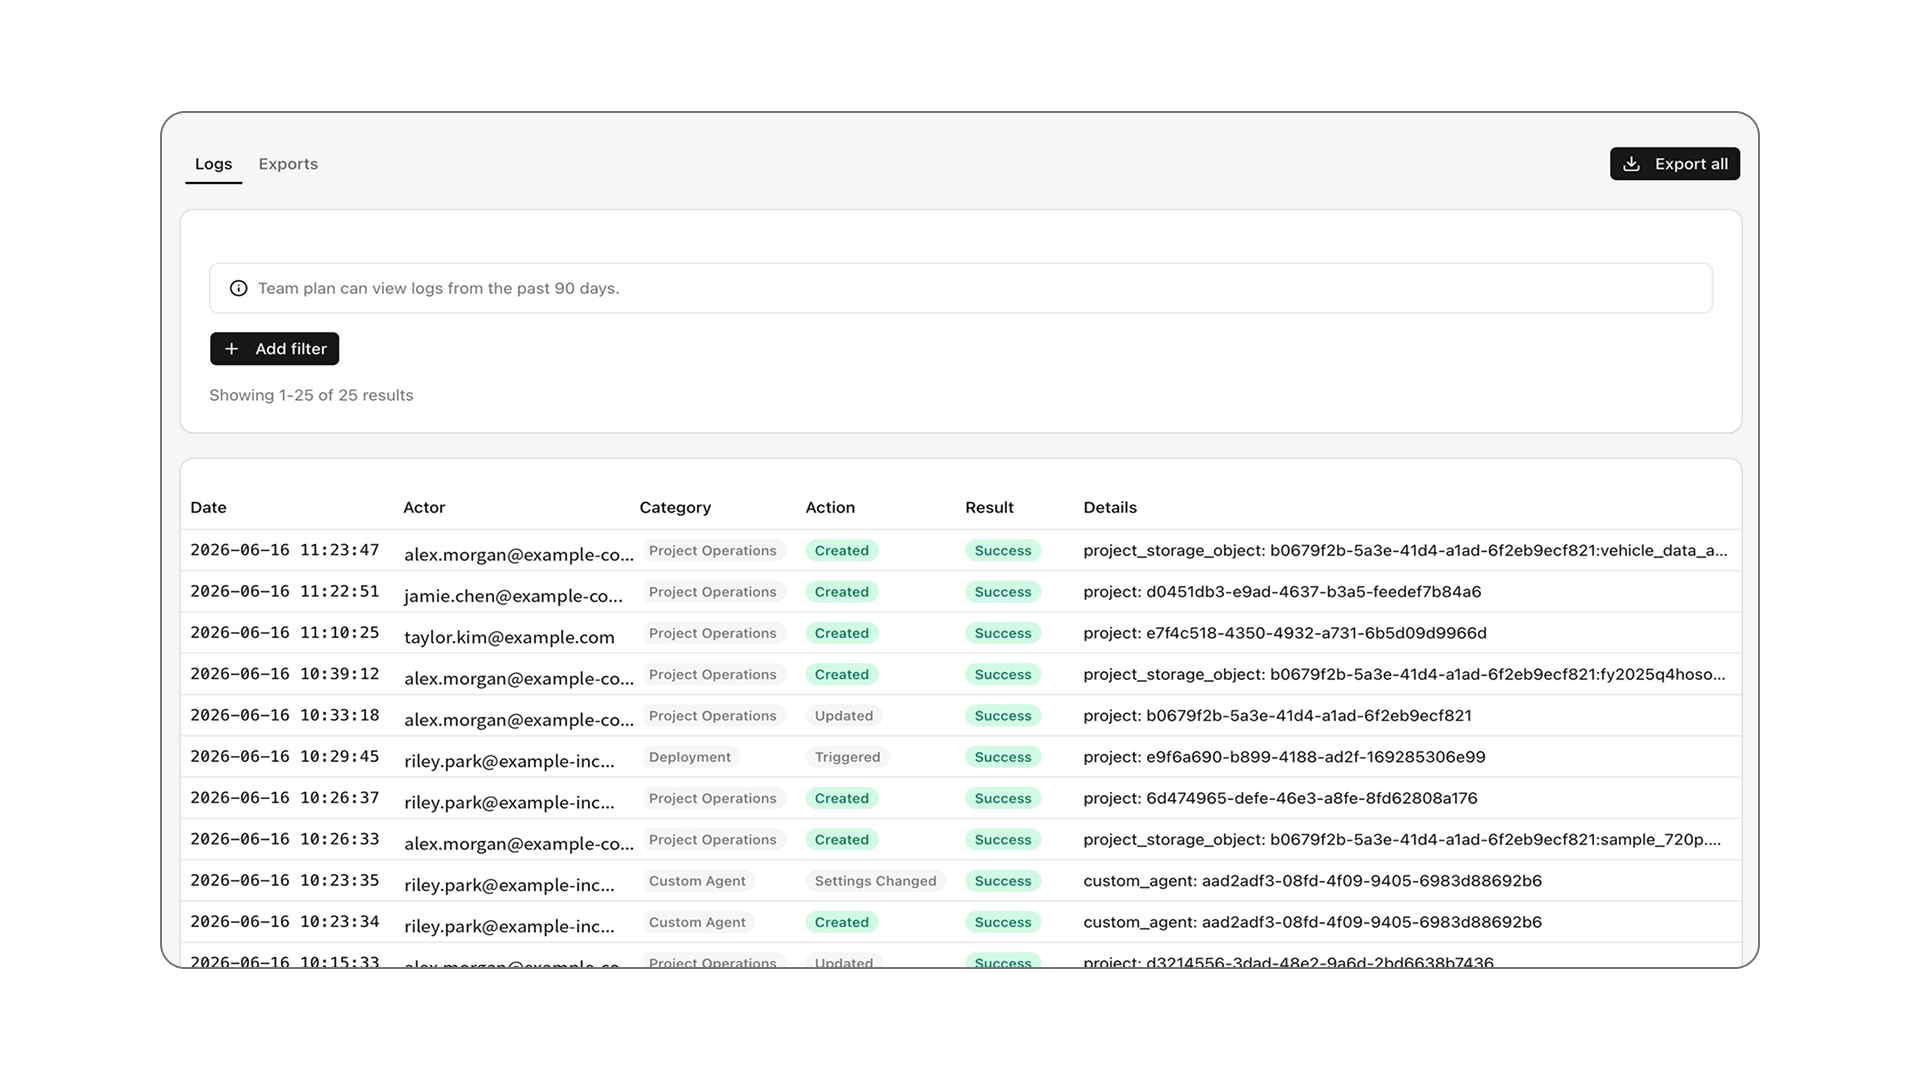
統制された自己解決を、チケットの行列なしで実現。
簡単な質問の8割は自己解決に。アナリストは付加価値の高い仕事に時間を取り戻せます。
- SQLの当て推量ではなく、セマンティックレイヤー上で自己解決
- チケットが減り、作業の中断も減少
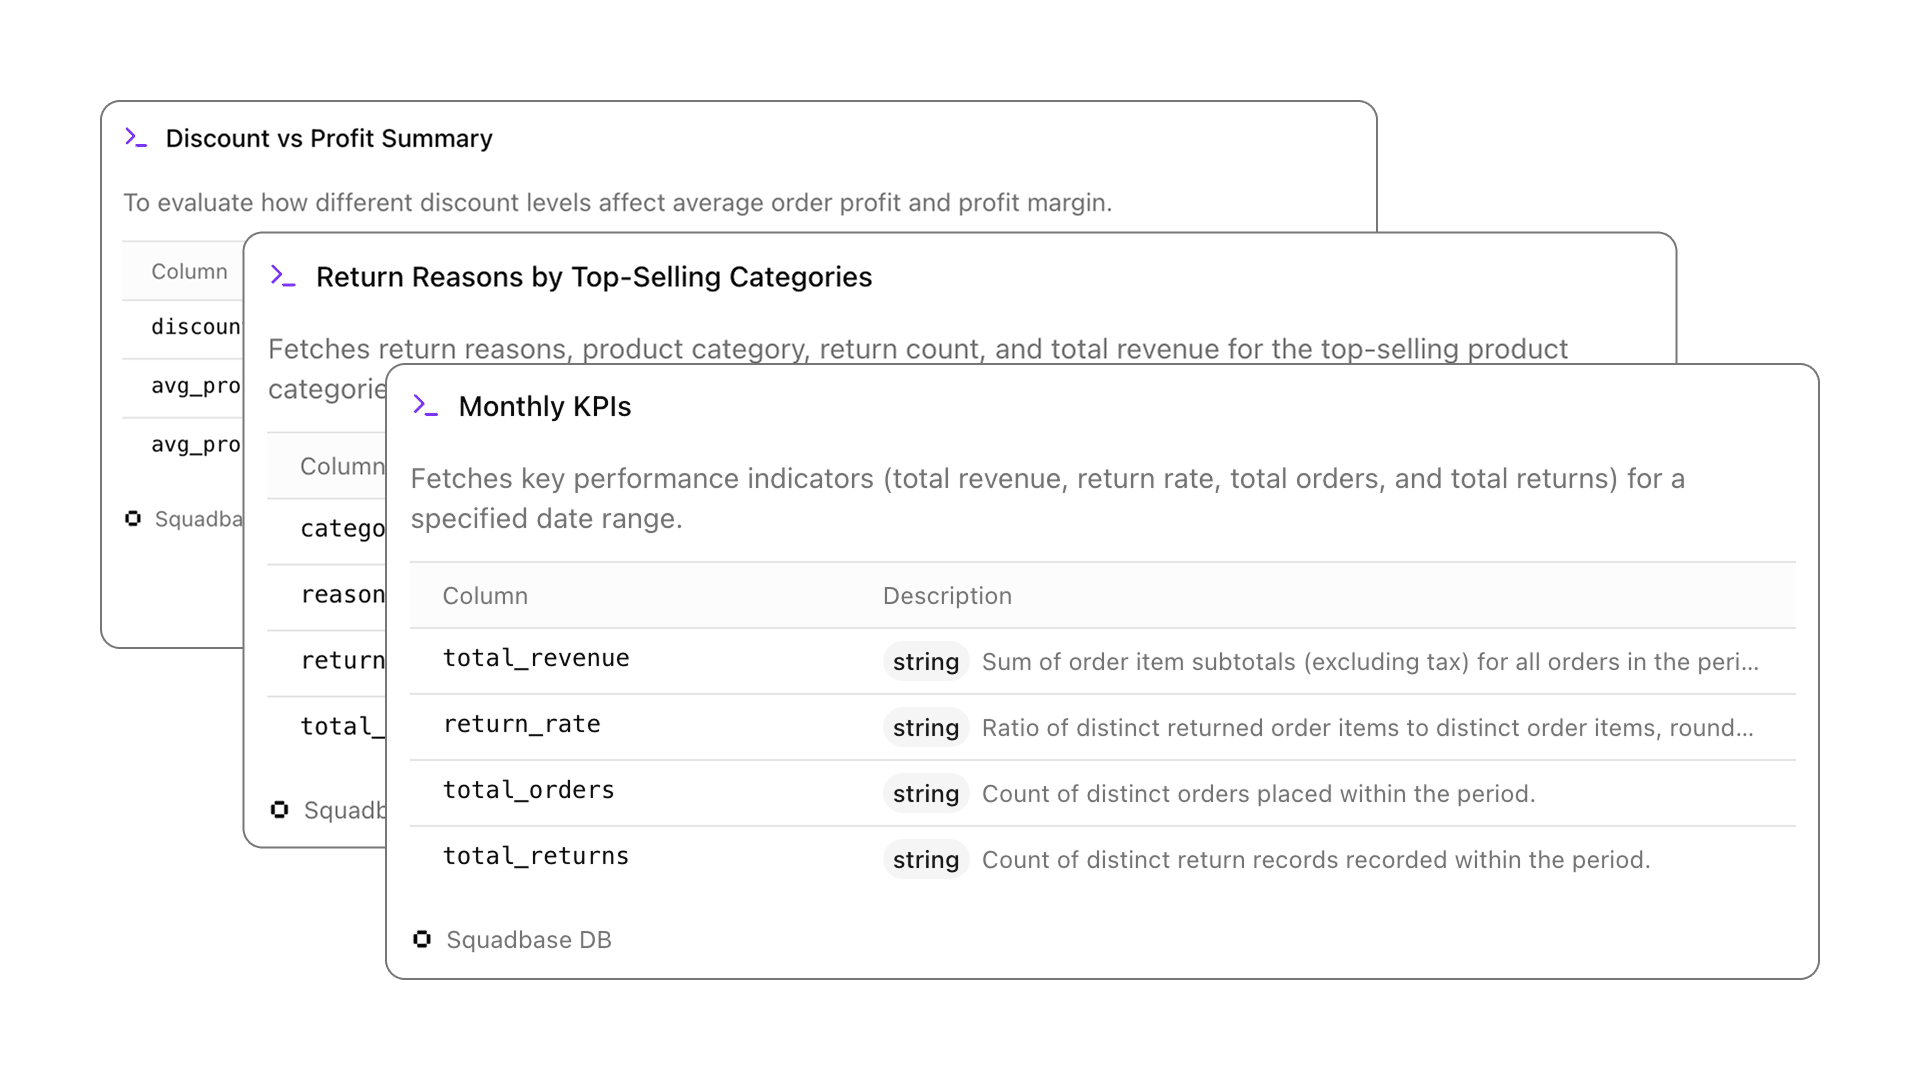
信頼できるデータモデル。すべてのチームで、同じひとつの数字を。
すべての回答は、チームが認定したメトリクス定義を使用します。独自集計も、数字のズレも生まれません。
- すべてのステークホルダーにとって唯一の信頼できる情報源
- 定義はフリーテキストではなく、実行可能なコードとして固定
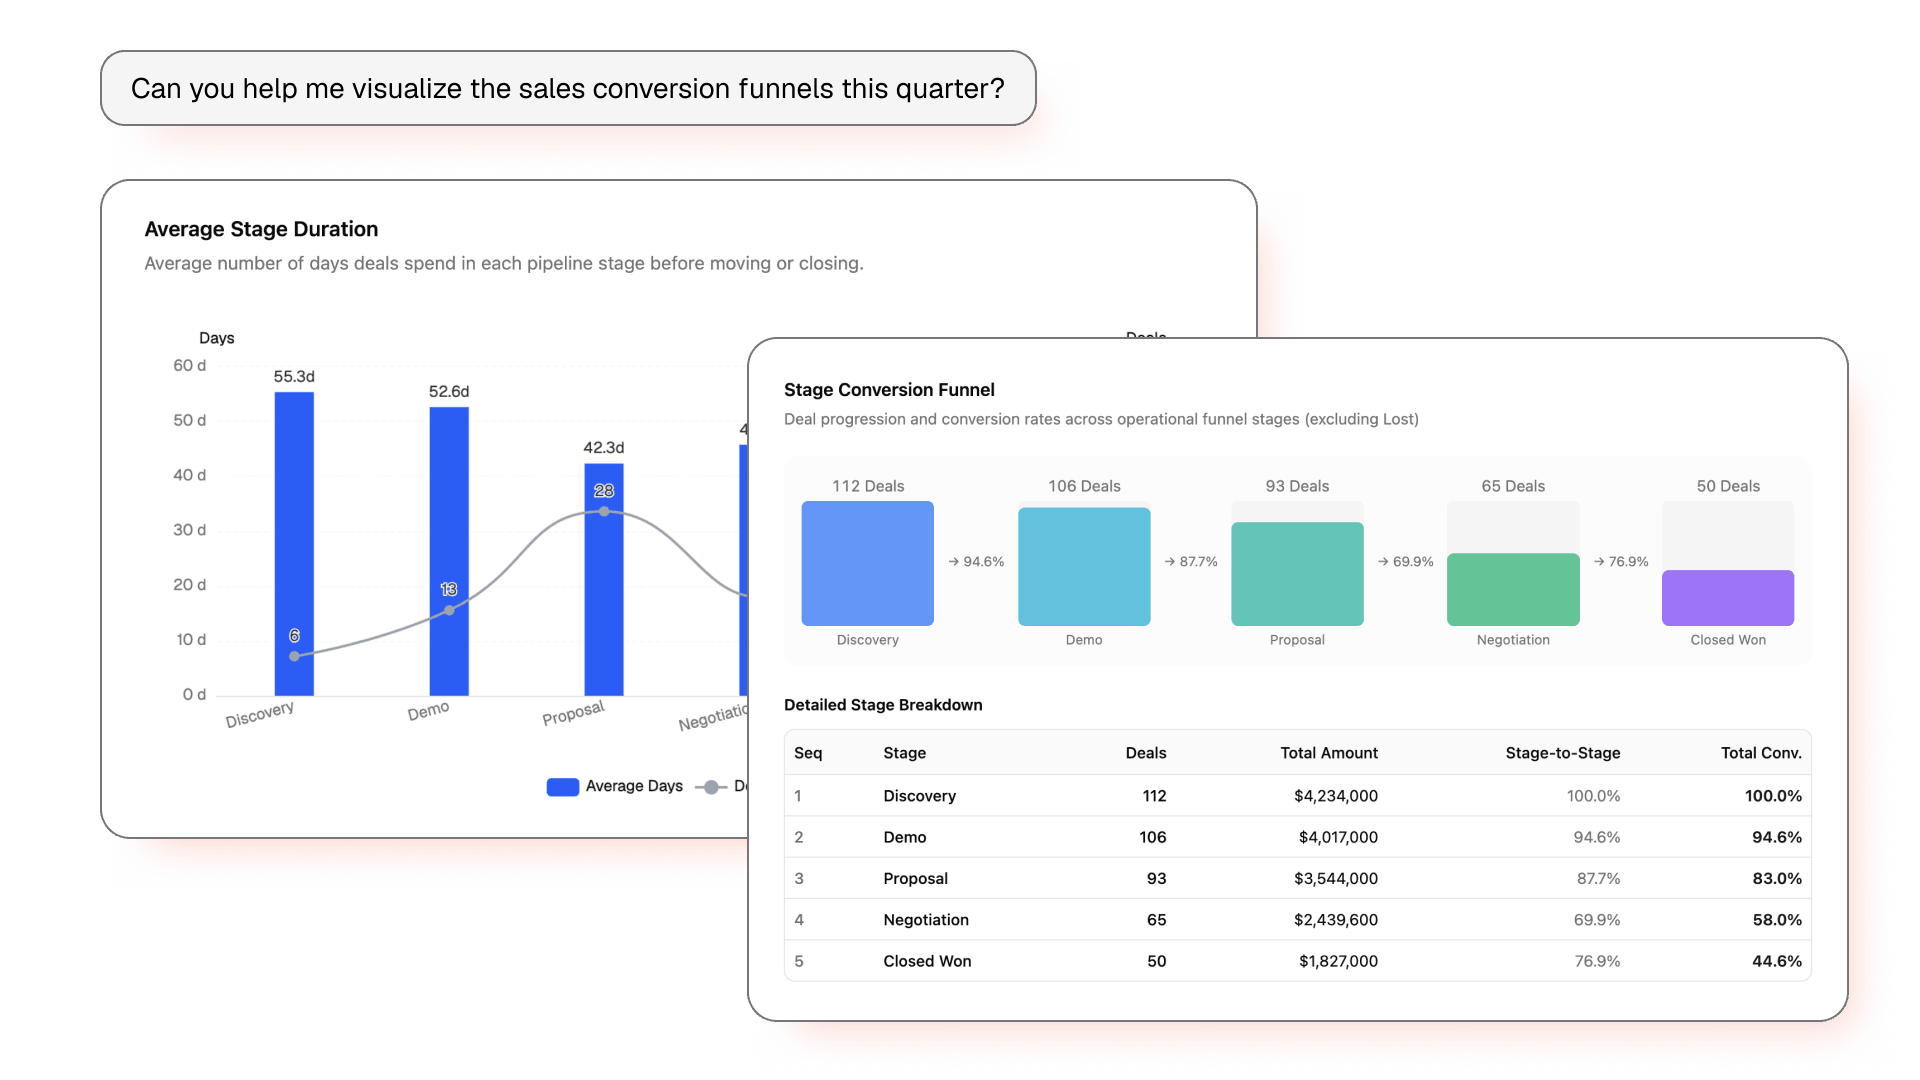
ひとつのエージェントで、データスタック全体をカバー。
接続は一度だけ。データチームがモデルを一度整備すれば、全社がその恩恵を受けられます。
- Snowflake、BigQuery、dbt、Redshift、Postgres、Looker、Tableau
- 新たなデータサイロや移行は不要
比較
AI分析 vs. 従来の分析。
AI分析 | 従来の分析 | |
|---|---|---|
| アプローチ | 統制されたモデル上で自己解決。 | 依頼のたびにアナリストがレポートを作成。 |
| スピード | リアルタイムで即座に回答。 | チケットの行列で遅延。 |
| ガバナンス | 信頼できるセマンティックレイヤーに基づく。 | 定義がチームごとにばらつく。 |
| スケール | 人員を増やさずにアクセスをスケール。 | アナリストのキャパシティに制約される。 |
| 使いやすさ | 対話形式で、ステークホルダーにも使いやすい。 | SQLやBIのスキルが必要。 |
データチームの活用例
アドホックな作業を減らし、レバレッジを高める。
アドホックな依頼を減らす
ステークホルダーの質問を自己解決
単発のレポート依頼を削減
再利用可能な統制された回答メトリクスを一元管理
唯一の信頼できる情報源
認定されたメトリクス定義
チーム間で一貫した回答データアクセスをスケール
非技術者ユーザーもすぐに利用開始
自然な言葉での問い合わせ
SQLのボトルネックを解消付加価値の高い分析に集中
アナリストの時間を取り戻す
より高度なモデリング作業
プロアクティブなインサイト提供
仕組み
データモデルから回答まで、3つのステップで。
01
ウェアハウスとセマンティックモデルを接続。
02
ステークホルダーが自然言語で質問。
03
数秒で、統制されたAI生成ダッシュボードを取得。
- AWS Athena
- AWS Billing
- Airtable
- Amplitude
- Asana
- Attio
- Azure Cosmos DB
- Azure SQL
- Backlog
- BigQuery
- ClickHouse
- ClickUp
- Customer.io
- Databricks
- Freshdesk
- Freshsales
- Freshservice
- Gamma
- Gemini
- GitHub
- Gmail
- Google Analytics
- Google Audit Log
- Google Calendar
- Google Search Console
- Grafana
- Hacker News
- HubSpot
- InfluxDB
- Intercom
- JDBC
- Jira
- Linear
- Mailchimp
- Mixpanel
- MongoDB
- MySQL
- Notion
- OpenAI
- Oracle Database
- Outlook
- PostgreSQL
- Power BI
- Redshift
- SQL Server
- Salesforce
- Semrush
- Sentry
- Snowflake
- Stripe
- Supabase
- Tableau
- TiDB
- Wix Store
- Zendesk
- dbt
- kintone
- monday.com







簡単な質問はステークホルダー自身が自己解決できるようになったので、データチームはようやく難しい課題に取り組む時間を持てるようになりました。
データチームの疑問に、答える。
自己解決による回答は、ガバナンスが保たれますか?
はい。AIデータエージェントは信頼できるセマンティックレイヤーに基づいて推論するため、すべての自己解決による回答はチームが認定した正確なメトリクス定義を使用します。ガバナンスとスピードは、もはやトレードオフではありません。
データチームの代わりになりますか?
いいえ。Squadbaseは反復的で付加価値の低い依頼を肩代わりするため、アナリストは価値の高いモデリング作業に集中できます。データチームがモデルを一度整備すれば、あとはエージェントが対応します。
自社のスタックのどの部分に接続できますか?
Squadbaseは、Snowflake、BigQuery、dbt、Redshift、Postgres、Looker、Tableau、スプレッドシートに接続します。新たなデータサイロや移行を強いることなく、既存のスタック全体で機能します。
非技術者のステークホルダーでも安全に使えますか?
はい。ステークホルダーは簡単な言葉で質問し、統制されたデータモデルに基づいた回答を得られます。基盤となるSQLやスキーマに直接触れることはありません。
Squadbaseはどのようにメトリクス定義の一貫性を保っていますか?
ビジネス定義は、自由記述の説明文ではなく、テスト済みの実行可能なコードとして保存されます。すべての回答は同じ認定されたロジックで実行されるため、誰が質問しても常に同じ正しい数値が得られます。